نحن مستعدون لمساعدتك
الذاكرة الموحدة لنماذج اللغة المحلية: ماذا يستطيع Ryzen AI Max+ 395 ومتى تحتاج بطاقة رسوميات
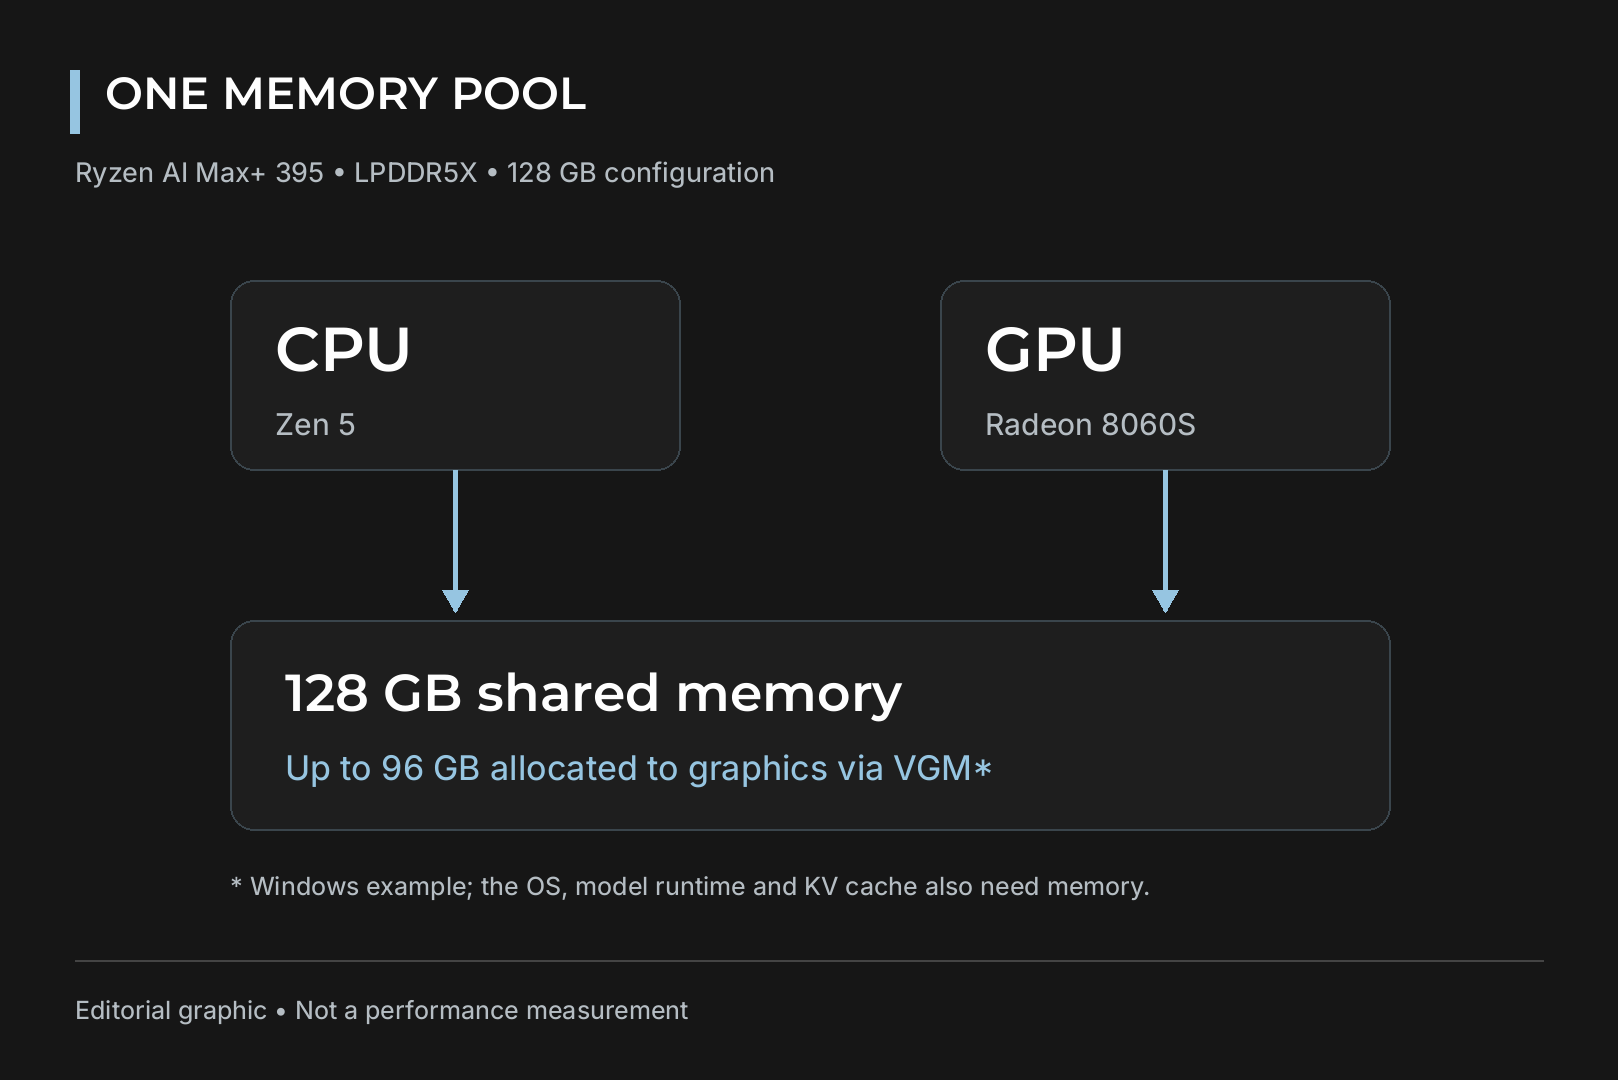
معالج AMD Ryzen AI Max+ 395، بالاسم الرمزي Strix Halo، يتيح لوحدة المعالجة المركزية ورسوميات Radeon 8060S مشاركة حتى 128 غيغابايت من ذاكرة LPDDR5X-8000. يمكن تخصيص حتى 96 غيغابايت للرسوميات، وهذا يكفي لتشغيل نماذج مثل gpt-oss-120b على شريحة واحدة. الثمن هو عرض النطاق: حوالي 256 غيغابايت/ث، وهو جزء مما تقدمه بطاقة رسوميات منفصلة عالية الأداء.
يشرح هذا الدليل كيف تعمل الذاكرة الموحدة، وأي النماذج تناسبها، ومدى سرعتها فعلياً، وكيف تختار بين Strix Halo وحاسوب ببطاقة رسوميات منفصلة.
الإجابة السريعة
- اختر بطاقة رسوميات منفصلة إذا كنت تشغّل غالباً نماذج حتى نحو 30B من المعاملات، أو تريد إجابات سريعة، أو تخطط لضبط دقيق للنماذج أو توليد الصور أو الألعاب بدقة عالية.
- اختر Ryzen AI Max+ 395 مع 128 غيغابايت إذا أردت نماذج Mixture of Experts (MoE) الكبيرة، من 100B فما فوق، محمّلة بالكامل على جهاز مدمج واحد.
- لا يكفي أي منهما وحده لنماذج dense بحجم 70B بسرعة دردشة مريحة. ذلك يحتاج مزيداً من VRAM عبر عدة بطاقات أو بطاقة محطة عمل بذاكرة كبيرة.
كيف تختلف الذاكرة الموحدة عن VRAM
في حاسوب تقليدي، لبطاقة الرسوميات ذاكرتها الخاصة (VRAM) وللمعالج ذاكرته النظامية. يعمل نموذج اللغة بسرعة فقط عندما تكون كل أوزانه في VRAM. إذا فاض النموذج إلى ذاكرة النظام، تمر الطبقات عبر ناقل PCIe فتنخفض الأداء بشدة.
لدى Strix Halo مجمع ذاكرة فعلي واحد على ناقل 256 بت، تصل إليه وحدة المعالجة المركزية والرسوميات مباشرة. تسمي AMD التقسيم Variable Graphics Memory، وتضبطه من BIOS أو AMD Software Adrenalin Edition. على نظام بـ 128 غيغابايت يمكن للرسوميات أخذ حتى 96 غيغابايت. للمقارنة، GeForce RTX 5090 لديها 32 غيغابايت من GDDR7، أي أن Strix Halo يوفّر للنموذج نحو ثلاثة أضعاف ذاكرة أقوى بطاقة استهلاكية من NVIDIA.
Ryzen AI Max+ 395 باختصار
| المواصفة | القيمة |
|---|---|
| الأنوية والخيوط | 16 أنوية Zen 5، 32 خيطاً |
| التردد | من 3.0 إلى 5.1 غيغاهرتز |
| الذاكرة المؤقتة | 16 ميغابايت L2، 64 ميغابايت L3 |
| الرسوميات | Radeon 8060S، 40 وحدة حساب RDNA 3.5، حتى 2900 ميغاهرتز |
| NPU | XDNA 2، 50 TOPS |
| أداء الذكاء الاصطناعي الإجمالي | حتى 126 TOPS عبر CPU وGPU وNPU |
| الذاكرة | حتى 128 غيغابايت LPDDR5X-8000، ناقل 256 بت |
| العملية التصنيعية | 4 نانومتر |
| الإعلان | يناير 2025 |
تذكّر أن رقم 126 TOPS هو مجموع كلي وليس أداء NPU وحده. لنماذج اللغة، الرسوميات هي التي تقوم بالعمل الثقيل.
كم تحتاج النماذج من الذاكرة
قاعدة تقريبية: اضرب عدد المعاملات في حجم المعامل بالبايت. ذلك بايتان عند 16 بت، وبايت واحد عند 8 بت، ونحو نصف بايت عند 4 بت، مع هامش لسياق KV cache.
| النموذج | البنية | الصيغة | حجم الأوزان |
|---|---|---|---|
| gpt-oss-120b | MoE | MXFP4 | حوالي 61 غيغابايت |
| Llama 4 Scout (109B إجمالي، 17B نشط) | MoE | 4-bit | يتسع في 96 غيغابايت |
| Llama 3.3 70B | Dense | Q4_K_M | حوالي 40 غيغابايت |
| Qwen3-30B-A3B | MoE، 3B نشط | 4-bit | حوالي 15 غيغابايت حسب القاعدة أعلاه، إضافة للسياق |
وفقاً لـ AMD، تدعم تعريفات Adrenalin 25.8.1 والأحدث نماذج حتى 128 مليار معامل بـ 4 بت على Windows، بينما يصل حد FP16 إلى حوالي 32B. لحساب خطوة بخطوة، راجع دليلنا عن كمية VRAM اللازمة لتشغيل Llama 70B وDeepSeek محلياً.
السعة ليست هي السرعة
لتوليد كل رمز جديد، يقرأ النموذج كل أوزانه النشطة من الذاكرة. لذلك يصبح عرض نطاق الذاكرة الحدّ الأساسي لسرعة التوليد.
هنا يقع تنازل Strix Halo. LPDDR5X-8000 على ناقل 256 بت يعطي حوالي 256 غيغابايت/ث نظرياً ونحو 215 غيغابايت/ث تحت الحمل الحقيقي، بحسب قياسات Codersera. RTX 5090 تقدّم حوالي 1792 غيغابايت/ث، أي نحو ثمانية أضعاف.
نتائج توليد الرموز على Strix Halo بحسب Codersera (Vulkan، تكميم 4 بت):
| النموذج | سرعة التوليد |
|---|---|
| Qwen3-30B-A3B (MoE) | حوالي 100 رمزاً/ث |
| gpt-oss-120b (MoE) | حوالي 55 رمزاً/ث |
| Llama 3.3 70B (dense) | حوالي 4 إلى 6 رموز/ث |
الفجوة بين نماذج MoE وdense تعود للبنية. نموذج MoE يفعّل عدداً قليلاً من الخبراء لكل رمز، فيُقرأ من الذاكرة بيانات أقلّ ولا تؤذي الذاكرة البطيئة بالقدر نفسه. نموذج dense بحجم 70B يقرأ كل الأوزان في كل رمز، فتنخفض السرعة إلى مستوى يبدو بطيئاً في المحادثة.
على النماذج الصغيرة، تتقدّم البطاقة المنفصلة بوضوح: قاست Codersera حوالي 186 رمزاً/ث على RTX 5090 مقابل 80 إلى 90 رمزاً/ث على Strix Halo مع نموذج 8B.
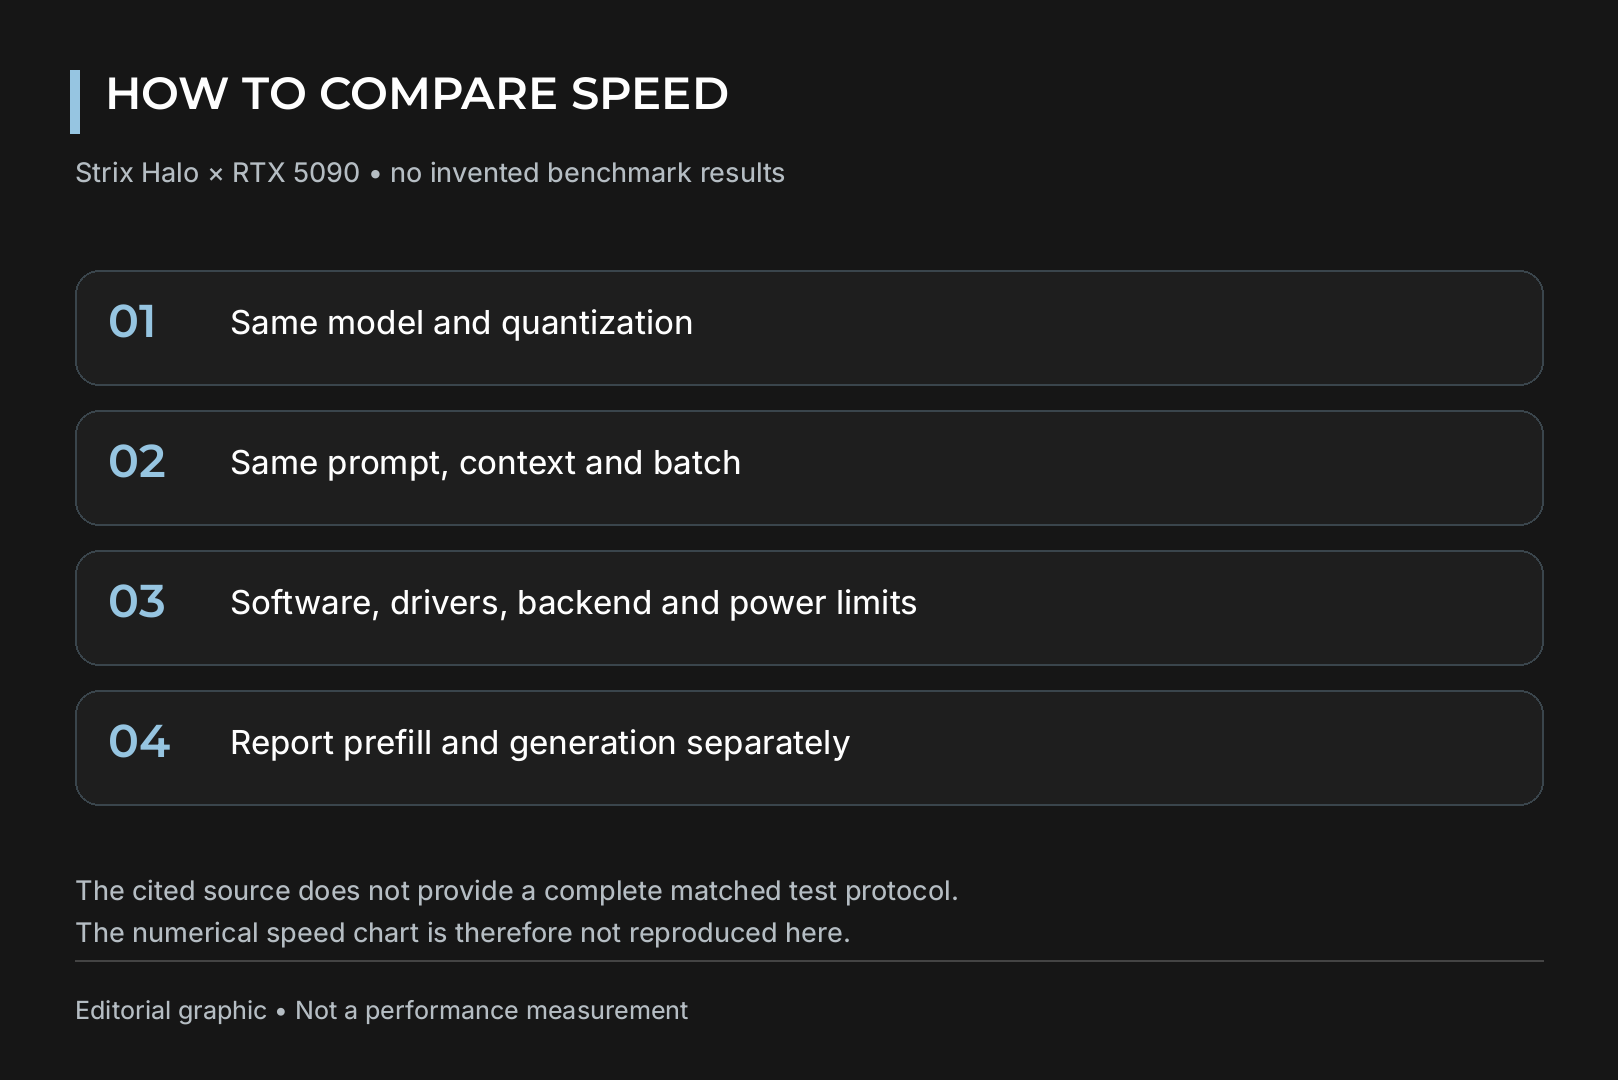
معالجة الموجّه الطويل (prefill) نقطة ضعف أخرى. هي مرتبطة بالحساب، و40 وحدة متكاملة لا تضاهي وحدة رسوميات منفصلة كبيرة. إذا غذّيت النموذج بمستندات طويلة، ستلاحظ الفرق.
البرامج والتعريفات
LM Studio وllama.cpp مع خلفية Vulkan هما الأشيع لتشغيل النماذج على Strix Halo. استخدم Adrenalin 25.8.1 أو أحدث لدعم نماذج 128B على Windows. تذكر AMD أيضاً سياقات حتى 256,000 رمز مع Flash Attention وQ8 KV cache.
دعم ROCm لهذه الشريحة لا يزال ينضج. توصي Codersera بـ Vulkan كخيار افتراضي، بينما يتفوق ROCm فقط عند السياقات الطويلة جداً. على Linux تتيح معاملات النواة للرسوميات مخاطبة ذاكرة أكبر من حد Windows.
للتدريب والضبط الدقيق، تبقى بطاقات NVIDIA المعيار بفضل منظومة CUDA والأدوات المبنية حولها.
صيغة GGUF هي الأنسب هنا، لأن LM Studio وllama.cpp يدعمانها. كقاعدة عملية، تكميم 4 بت توازن معقول بين الجودة والحجم، بينما 8 بت يضاعف متطلبات الذاكرة للنموذج نفسه.
ماذا عن الألعاب
Radeon 8060S أقوى بكثير من الرسوميات المدمجة المعتادة، لكنها ليست بديلاً عن بطاقة ألعاب منفصلة. في اختبار PCWorld بلغ متوسط Cyberpunk 2077 نحو 48.85 إطاراً/ث بدقة 1080p مع تتبع الأشعة Ultra وFSR 2.1 تلقائي، وانخفض إلى 28.8 إطاراً/ث عند 3440×1440.
قيود يجب معرفتها قبل الشراء
- ذاكرة ملحومة. LPDDR5X ملحومة على اللوحة، فاختر 128 غيغابايت من البداية إذا كنت تخطط لنماذج كبيرة.
- لا مسار لترقية الرسوميات. لا يمكن استبدال الرسوميات المدمجة. البطاقة الخارجية تتصل فقط عبر USB4، أو OCuLink إن وُجد في الطراز، وكلاهما يتنازل عن عرض النطاق.
- سرعة نماذج dense. نموذج dense بحجم 70B يُحمَّل، لكن التوليد يبقى بطيئاً.
- التبريد يختلف. قد تستهلك الشريحة حتى 120 واط بحسب النظام، لذا يعتمد الأداء الحقيقي كثيراً على هيكل كل مصنع وتبريده.
كيف تقرر
- أي نماذج تشغّل؟ حتى نحو 30B، حاسوب ببطاقة قوية واحدة يجيب أسرع بكثير. لنماذج MoE من 100B فأعلى على جهاز واحد، لـ Strix Halo مع 128 غيغابايت ميزة حقيقية.
- هل تحتاج سرعة تفاعلية؟ مساعدو البرمجة والوكلاء والدردشة يحتاجون عشرات الرموز في الثانية. مهام الدفعات الليلية تحتمل توليداً أبطأ.
- هل ستدرّب النماذج أو تلعب؟ الضبط الدقيق وتوليد الصور والفيديو وألعاب 4K كلها تفضّل بطاقات NVIDIA المنفصلة.
إذا ناسبك نظام يعتمد على بطاقة رسوميات، يمكنك تجهيزه لنماذجك في مُكوِّن HYPERPC.
الخلاصة
يقوم Ryzen AI Max+ 395 بما لا تستطيعه أي بطاقة رسوميات استهلاكية: يحتفظ بنموذج من 60 إلى 90 غيغابايت في ذاكرة تصل إليها الرسوميات دون تقسيمه على أجهزة عدة. يتألق مع نماذج MoE التي تقرأ جزءاً فقط من أوزانها لكل رمز. عندما تهمّ السرعة أو معالجة الموجّه أو التدريب أو الألعاب أكثر، يبقى حاسوب ببطاقة منفصلة الخيار الأقوى.
نوصي بـ
الأسئلة الشائعة إجابات مختصرة.
-
هل يشغّل Ryzen AI Max+ 395 نموذجاً بحجم 70B؟
نعم. Llama 3.3 70B بـ 4 بت يحتاج حوالي 40 غيغابايت ويتسع في الذاكرة، لكن توليداً بنحو 4 إلى 6 رموز في الثانية يجعل الدردشة بطيئة.
-
هل يسرّع NPU نماذج اللغة؟
ليس في الأدوات الشائعة. LM Studio وllama.cpp مع Vulkan يشغّلان النماذج على رسوميات Radeon 8060S. يُقدَّر NPU بـ 50 TOPS، ورقم 126 TOPS يجمع CPU وGPU وNPU.
-
هل تكفي 64 غيغابايت؟
لنماذج حتى نحو 30B بـ 4 بت غالباً نعم. لـ gpt-oss-120b الذي يحتاج حوالي 61 غيغابايت للأوزان وحدها، أو Llama 4 Scout، اختر 128 غيغابايت لأن الذاكرة لا تُرقّى لاحقاً.
 Arabic
 English